Producto
Prosodia Local
Reconocimiento de voz para español rioplatense que corre en tu servidor. Transcripción por lotes (batch) con hablantes, marcas de tiempo y tu glosario. Nada sale de tu red.
Hardware mínimo
| GPU | Una NVIDIA L4 (24 GB) o superior por servidor |
|---|---|
| Velocidad | 0,42× tiempo real en una L4: una hora de audio en unos 25 minutos |
| CPU, memoria, disco | Se dimensionan durante el piloto según tu volumen diario de audio. Te mandamos la lista de materiales antes de la instalación. |
| Sistema operativo | Linux x86-64 (Ubuntu LTS o Red Hat Enterprise Linux) con el driver de NVIDIA |
| Red | Sin conexión saliente. Solo red local, para la API y la carpeta compartida. |
Formatos de audio
| Contenedores | WAV (PCM), FLAC, MP3, OGG/Opus |
|---|---|
| Frecuencia de muestreo | 8 kHz (teléfono) y 16 kHz (sala) de forma nativa. Las demás frecuencias se remuestrean a 16 kHz. |
| Canales | Mono o estéreo. En estéreo, cada canal se puede transcribir como un hablante propio. |
| Modo | Solo por lotes. Sin streaming en vivo; ver límites. |
Glosario por cliente
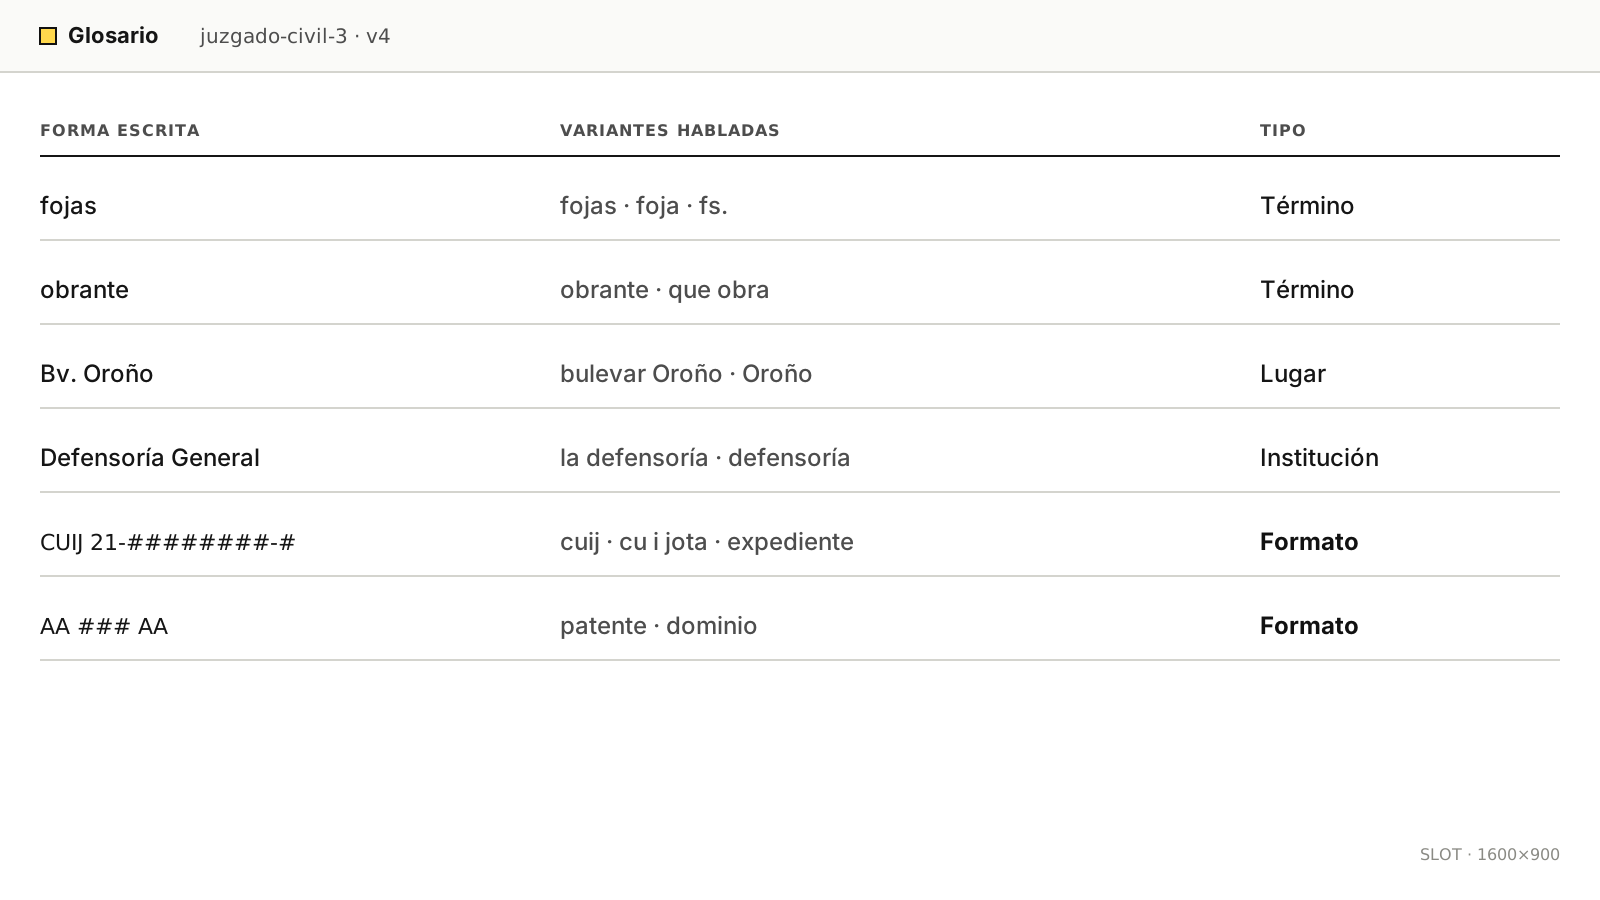
Cada cliente tiene su propio glosario, cargado antes del primer archivo. Contiene tres tipos de entradas:
- Términos: nombres de productos, apellidos, nombres de calles, vocabulario jurídico.
- Variantes habladas: cómo se dice realmente cada término, incluidas abreviaturas y apodos.
- Formatos: patrones de números de expediente, números de cuenta y patentes. La salida se verifica contra ellos.
Los glosarios tienen versiones. Cada transcripción registra la versión del glosario que usó, así un resultado se puede reproducir.
Diarización
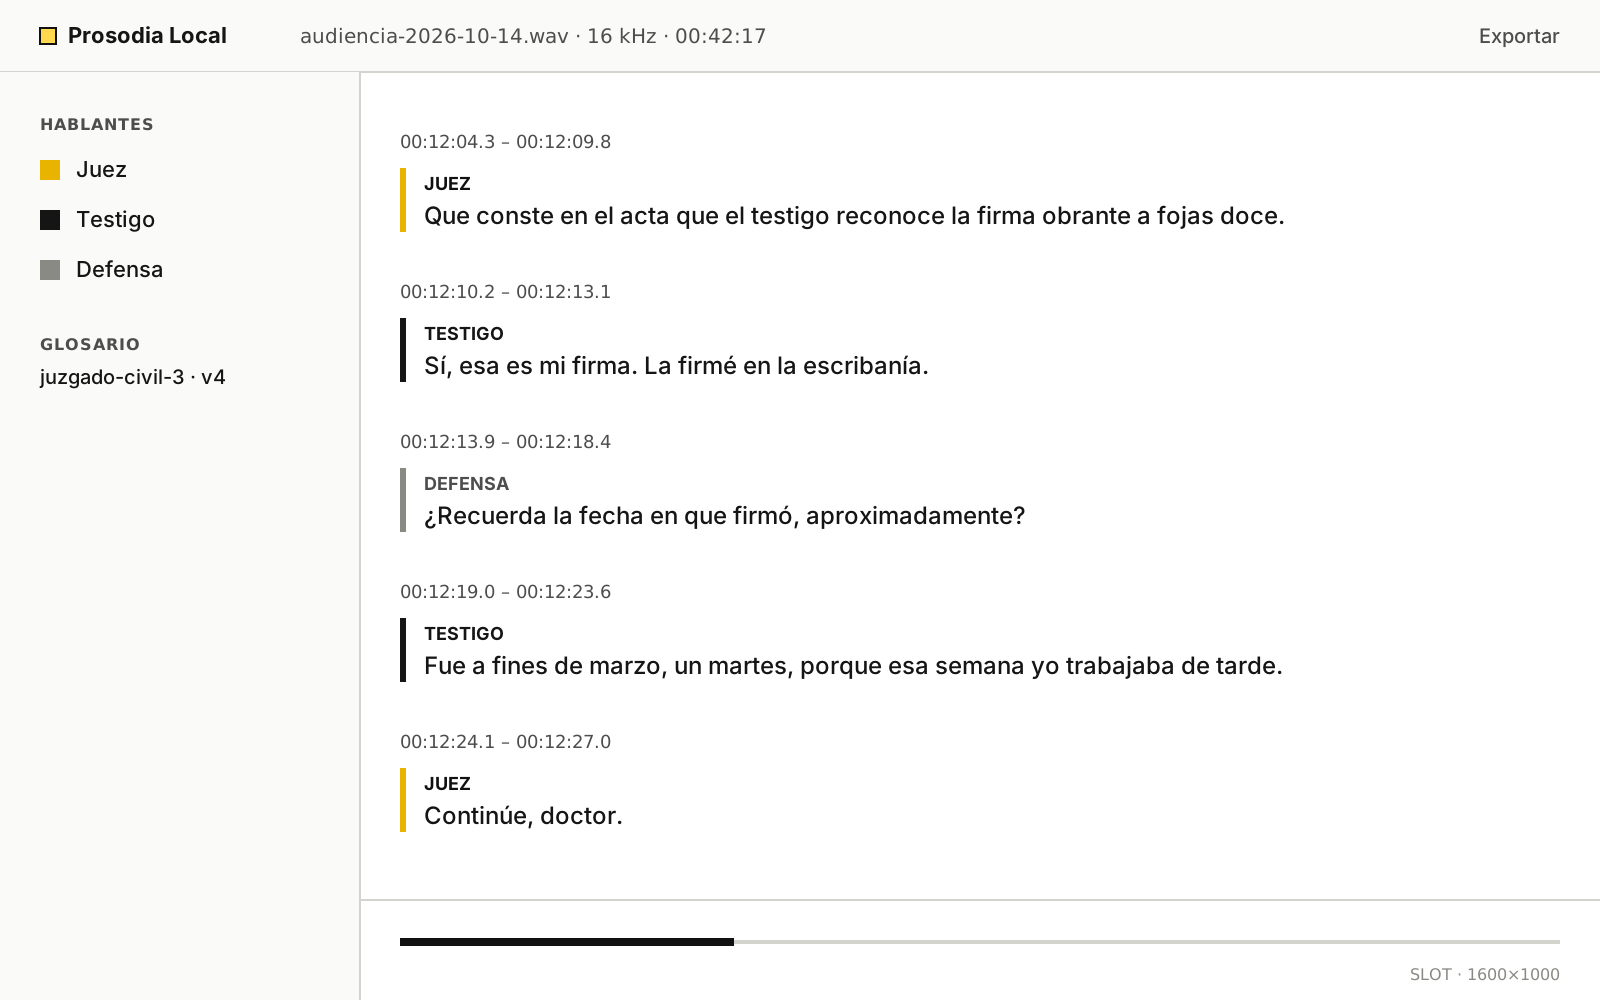
La diarización responde quién habló y cuándo. Prosodia Local separa hasta 6 hablantes por grabación y etiqueta cada turno con su hora de inicio y de fin.
| Hablantes en la grabación | DER |
|---|---|
| 2 | 8,7 % |
| Hasta 6 | 14,2 % |
Los hablantes salen como S1 a S6. Podés renombrarlos (agente, cliente, juez, testigo) y los nombres se mantienen en todas las exportaciones. Las definiciones y el protocolo están en el benchmark.
Exportación
| Formato | Contenido |
|---|---|
| TXT | Texto plano, un turno por línea, con hablante y hora de inicio |
| DOCX | Documento con hablantes y marcas de tiempo, listo para editar |
| SRT, WebVTT | Subtítulos para reproducir junto al audio |
| JSON | Palabras con tiempos de inicio y fin, confianza y hablante, para tus propios sistemas |
Integración: carpeta o API
Carpeta
Dejá los archivos de audio en una carpeta vigilada del servidor o de un recurso compartido de red. Las transcripciones aparecen en la carpeta de salida, en los formatos que elegiste. No hace falta programar.
API
HTTPS en tu red local, con un token por aplicación cliente. Mandá un archivo y después consultá el trabajo hasta que termine.
# Ejemplo de solicitud. El host y el token se configuran en la instalación.
curl -H "Authorization: Bearer $TOKEN" \
     -F "audio=@hearing.wav" -F "glossary=juzgado-civil-3" \
     https://prosodia.internal/api/v1/jobs

curl -H "Authorization: Bearer $TOKEN" \
     https://prosodia.internal/api/v1/jobs/$JOB_ID
Los requisitos del servidor, el hardening y las actualizaciones sin conexión están en Precios y despliegue.
Módulo
Acta, para juzgados
Acta convierte la grabación de una audiencia en un borrador de acta, con el formato propio del juzgado. Está en piloto en un juzgado.
- Campos del encabezado completados a partir de la causa: expediente, carátula, juzgado y fecha.
- Hablantes etiquetados por rol procesal: juez, fiscal, defensa, testigo.
- Una marca de tiempo en cada turno, para poder cotejar cada pasaje con el audio.
- Un hash SHA-256 del audio original impreso en el acta, para mostrar que el archivo no se alteró.
- Exportación a DOCX con la plantilla del juzgado.
Acta produce un borrador. El secretario lo revisa y lo firma; el sistema no firma nada.