Benchmark
Protocolo, corpus y resultados
Cada tasa de error y cada velocidad de este sitio salen de la evaluación que se describe acá. Primero las definiciones, después el protocolo, después los números.
Definiciones
WER: tasa de error por palabras
WER = (S + D + I) / N
- S
- Sustituciones: una palabra de la referencia reemplazada por otra distinta.
- D
- Omisiones: una palabra de la referencia que falta en la salida.
- I
- Inserciones: una palabra de la salida sin correspondencia en la referencia.
- N
- Cantidad de palabras de la referencia humana.
Una WER de 11,4 % significa 114 errores cada 1.000 palabras de referencia. La WER puede superar el 100 % cuando la salida inserta muchas palabras.
DER: tasa de error de diarización
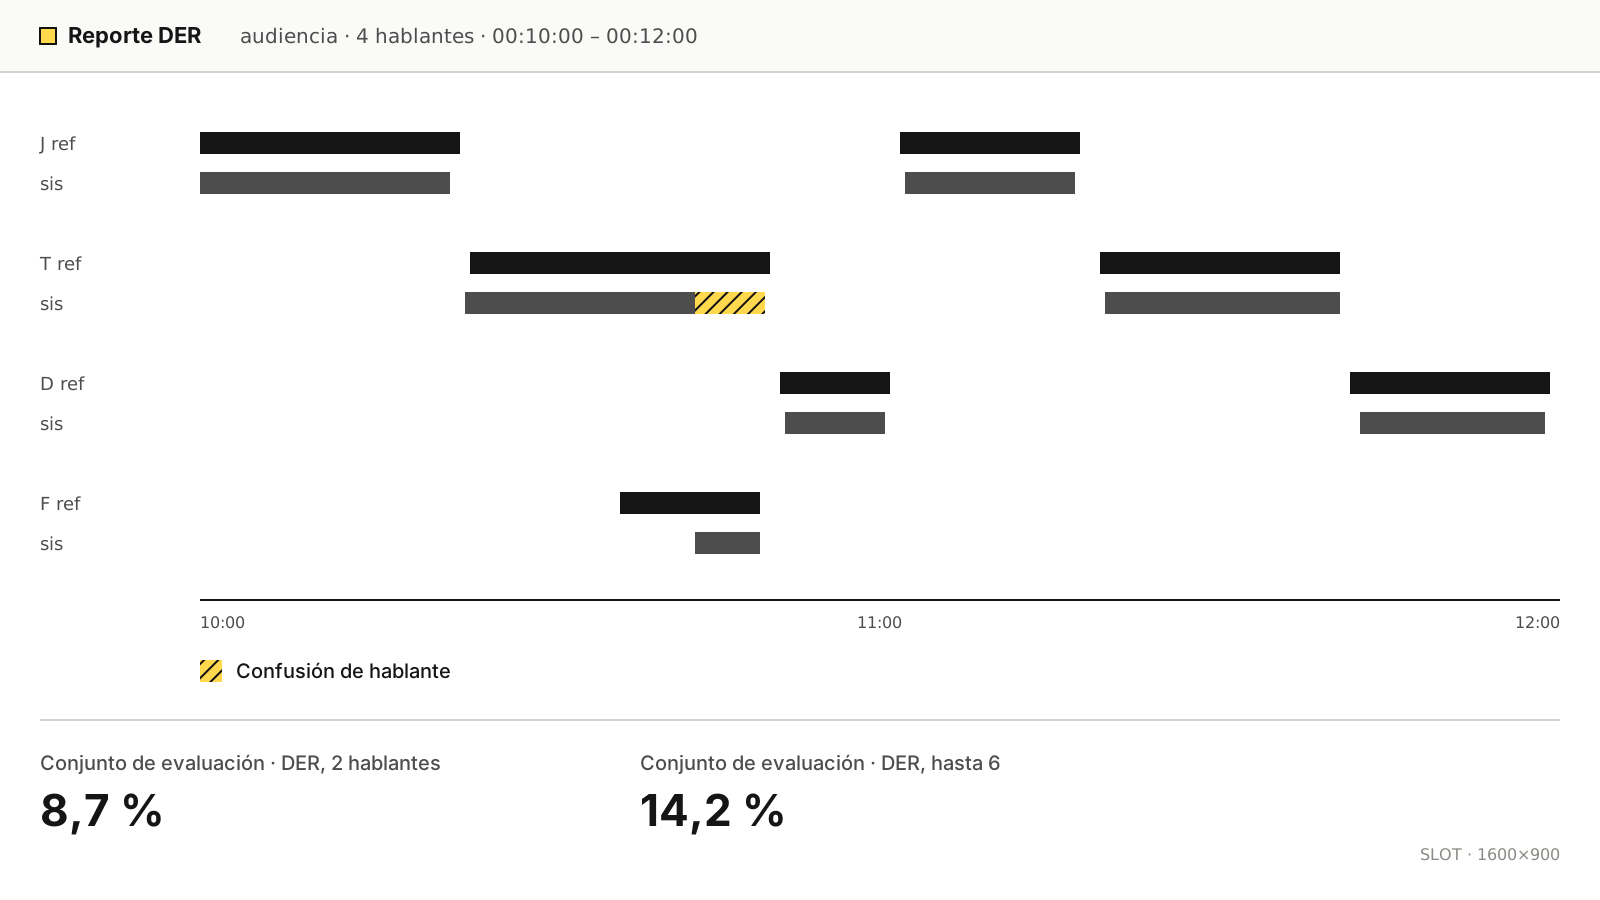
DER = (no detectada + falsa alarma + confusión) / tiempo total de habla
- No detectada
- Habla etiquetada como silencio.
- Falsa alarma
- Silencio o ruido etiquetado como habla.
- Confusión
- Habla atribuida al hablante equivocado.
La DER mide quién habló y cuándo, no qué se dijo. Se calcula en segundos y es independiente de la WER.
Protocolo
- El conjunto de evaluación se separa del de entrenamiento por hablante: ningún hablante de ese conjunto aparece en los datos de entrenamiento.
- Los dos sistemas reciben los mismos archivos en su frecuencia de muestreo original. Sin reducción de ruido ni segmentación manual.
- Whisper large-v3 corre localmente con sus pesos abiertos, con el idioma fijado en español y la configuración de decodificación por defecto.
- Prosodia Local corre en una NVIDIA L4 sin ningún glosario de cliente cargado.
- Las referencias se transcriben a mano y las revisa un segundo anotador.
- La referencia y la salida se normalizan de la misma manera antes de evaluar: minúsculas, sin puntuación, números escritos en palabras. Las tildes se mantienen, así que “esta” y “está” cuentan como palabras distintas.
- La WER se calcula sobre todas las palabras de cada tipo de grabación en conjunto, no como promedio por archivo.
Corpus
Corpus: 1.900 horas
| Fuente | Horas | Estado |
|---|---|---|
| Grabado por Prosodia en Rosario | 214 h | Propio |
| Licenciado por terceros | 1.686 h | Licenciado |
| Total | 1.900 h |
Evaluación: 15 horas
| Fuente | Horas | Estado |
|---|---|---|
| Common Voice, español de Argentina (es-AR) | 6 h | Público, CC0 |
| Grabado por Prosodia | 9 h | Propio, nunca usado para entrenamiento |
| Total | 15 h |
El conjunto de evaluación está separado por hablante. Ninguno de sus hablantes aparece en los datos de entrenamiento.
Resultados por tipo de grabación
| Tipo de grabación | Prosodia Local | Whisper large-v3 | Diferencia |
|---|---|---|---|
| Teléfono, 8 kHz (contact center) | 11,4 % | 28,3 % | −16,9 p. p. |
| Sala de audiencias, 16 kHz | 6,2 % | Sin medir todavía | — |
| Lectura limpia | 4,1 % | 5,1 % | −1,0 p. p. |
Whisper large-v3 es un modelo multilingüe general y no se adaptó a este audio. En lectura limpia, los dos sistemas están cerca. La brecha se abre en el audio telefónico de 8 kHz, donde se combinan el voseo, la elisión y una banda de frecuencias angosta.
Whisper large-v3 todavía no se corrió sobre el conjunto de sala de audiencias. Publicamos la cifra cuando esté medida; no la extrapolamos.
Desglose por acento
| Grupo de acento | Provincias | WER de Prosodia Local |
|---|---|---|
| Rioplatense, Litoral | Santa Fe, Entre Ríos | Pendiente |
| Rioplatense, Buenos Aires | Ciudad de Buenos Aires y área metropolitana | Pendiente |
| Cordobés | Córdoba | Pendiente |
| Cuyano | Mendoza, San Juan, San Luis | Pendiente |
| Noroeste (NOA) | Salta, Jujuy, Tucumán, Catamarca, Santiago del Estero | Pendiente. Límite conocido |
El acento del NOA es una falla documentada. La causa está en Qué no hace.
Diarización
| Hablantes en la grabación | DER |
|---|---|
| 2 | 8,7 % |
| Hasta 6 | 14,2 % |
La diarización admite hasta 6 hablantes por grabación. El habla superpuesta de más de 1,5 s es una falla conocida; ver Qué no hace.
Velocidad
0,42× tiempo real en una NVIDIA L4. Una grabación de una hora está lista en unos 25 minutos. El procesamiento es solo por lotes (batch); no hay streaming en vivo.
Qué está licenciado y qué es nuestro
- 214 h fueron grabadas por Prosodia en Rosario, con consentimiento escrito de cada hablante. Son propiedad de Prosodia.
- 1.686 h están licenciadas por terceros para entrenar modelos. Prosodia no es dueña de esas horas y no las redistribuye.
- Las 6 h de Common Voice son públicas bajo CC0 y se usan solo para evaluación.
- Las 9 h de audio de evaluación de Prosodia nunca se usan para entrenamiento.
- El audio de los clientes no se usa para entrenamiento. Se queda en el servidor del cliente.
Estas son mediciones propias. La prueba de banco aplica la misma evaluación a tu audio.